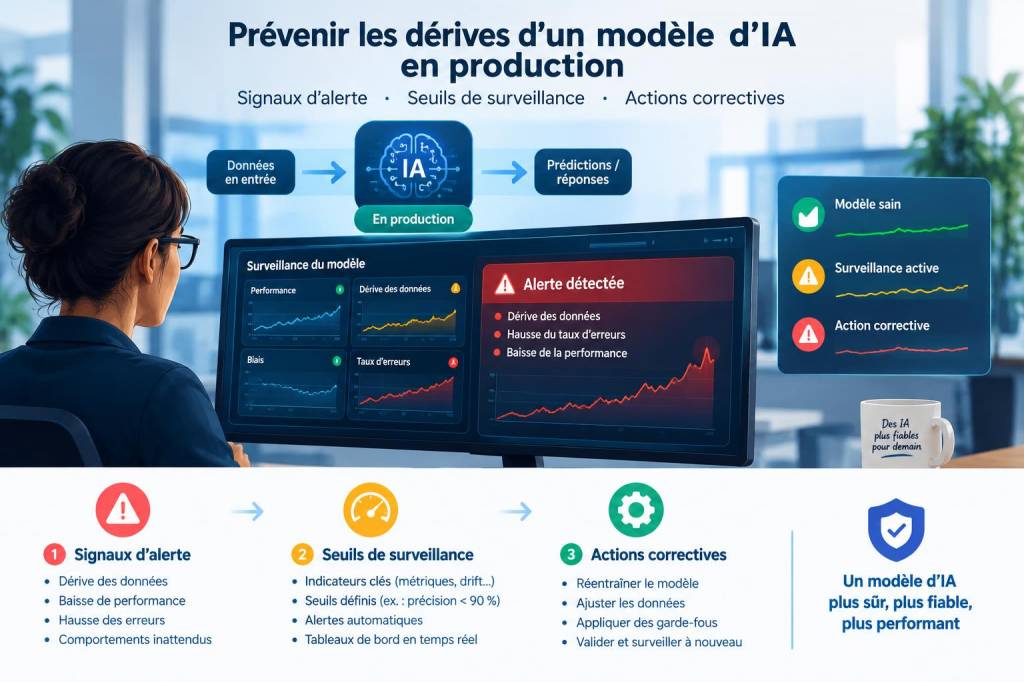
Quand un modèle d’IA passe en production, je considère que le plus difficile commence souvent après la mise en service. Beaucoup d’équipes respirent enfin une fois le déploiement terminé, alors que le vrai travail de vigilance débute à cet instant précis. Un modèle peut sembler performant en environnement de test, puis se dégrader silencieusement une fois confronté à des données réelles, à des usages inattendus, à des changements de contexte ou à des dérives dans la qualité des entrées. C’est précisément pour cette raison que je m’attache toujours à mettre en place une surveillance continue, avec des signaux d’alerte clairs, des seuils de référence et des actions correctives prêtes à être déclenchées sans délai.
Dans les faits, prévenir les dérives d’un modèle d’IA ne consiste pas seulement à surveiller son exactitude. Il faut observer l’évolution des données, détecter les comportements inhabituels, vérifier l’équilibre des résultats et garder un œil sur les effets métier. Un modèle peut afficher des scores flatteurs tout en produisant des décisions moins pertinentes, plus coûteuses ou moins équitables. C’est là que mon approche devient très pragmatique : je cherche à relier les métriques techniques aux impacts concrets sur les utilisateurs, les équipes et l’organisation.
Ce que j’appelle une dérive en production
Une dérive ne signifie pas forcément qu’un modèle « ne fonctionne plus ». Elle peut être lente, discrète et parfois presque invisible au début. J’observe généralement plusieurs formes de dérive : la dérive des données d’entrée, lorsque les informations reçues par le modèle changent par rapport à celles observées à l’entraînement ; la dérive de concept, lorsque la relation entre les entrées et la cible évolue ; la dérive de performance, lorsque les résultats se détériorent sur les usages réels ; et la dérive d’usage, lorsque les personnes contournent le système ou l’emploient dans un contexte différent de celui prévu.
Je me méfie particulièrement des situations où les indicateurs restent stables pendant plusieurs semaines, puis basculent soudainement. Dans beaucoup de cas, les premiers signaux existent déjà, mais ils ne sont pas suivis au bon endroit, ou ils sont noyés dans une masse de données trop vaste. C’est pourquoi je recommande d’identifier dès le départ ce que l’on veut surveiller, pourquoi on le surveille, et à partir de quel écart une alerte devient pertinente.
Les signaux d’alerte que je surveille en priorité
Je distingue les signaux d’alerte techniques, statistiques et métier. Les premiers concernent la qualité des données et des sorties. Les seconds concernent les écarts de distribution ou les variations anormales. Les troisièmes reflètent l’impact sur la valeur produite par le système. Ce triptyque évite de tomber dans une surveillance trop étroite, centrée uniquement sur des mesures mathématiques qui ne disent pas tout.
- Variation de la distribution des données d’entrée : si les caractéristiques observées en production s’éloignent trop de celles utilisées à l’entraînement, je considère cela comme un signal fort.
- Hausse des valeurs manquantes ou incohérentes : une qualité de données qui se dégrade entraîne souvent une baisse progressive de fiabilité.
- Modification du taux d’erreur : une augmentation du nombre de faux positifs, de faux négatifs ou d’écarts importants par rapport à la réalité doit être suivie de près.
- Dégradation des performances par segment : il m’importe de vérifier si certaines populations, certains marchés ou certains cas d’usage sont plus touchés que d’autres.
- Allongement des délais de réponse : dans certains systèmes, une hausse de latence signale un problème d’infrastructure, de charge ou d’intégration.
- Retour inhabituel des utilisateurs : une hausse des corrections manuelles, des réclamations ou des contournements est souvent plus parlante qu’un tableau de bord isolé.
J’ai aussi appris à ne pas négliger les signaux faibles. Un petit écart répété sur plusieurs jours vaut parfois davantage qu’un grand écart ponctuel. La régularité d’une anomalie raconte souvent une histoire plus utile que son amplitude seule.
Définir des seuils de surveillance qui ont du sens
Je préfère toujours des seuils pensés pour le contexte plutôt que des seuils « universels ». Un modèle de recommandation, un système de détection de fraude ou un outil d’aide à la décision ne supportent pas les mêmes marges d’alerte. Un seuil pertinent doit s’appuyer sur trois éléments : l’historique des performances, la sensibilité métier et la capacité de réaction de l’équipe.
Par exemple, si un modèle affiche habituellement une précision très stable, une baisse modérée mais continue peut suffire à déclencher une investigation. À l’inverse, dans un environnement où les données fluctuent naturellement, un seuil trop rigide produira des fausses alertes en permanence et finira par être ignoré. Je cherche donc un équilibre entre vigilance et bruit opérationnel.
| Indicateur | Ce que je cherche à observer | Seuil possible | Réaction attendue |
|---|---|---|---|
| Distribution des données | Écart par rapport à l’historique | Écart persistant sur plusieurs périodes | Analyse de l’origine des changements |
| Taux d’erreur | Baisse de qualité prédictive | Variation au-delà d’une marge définie par segment | Vérification des cas d’échec |
| Latence | Ralentissement du service | Dégradation répétée au-delà du niveau attendu | Contrôle de l’infrastructure |
| Retours métier | Hausse des corrections humaines | Augmentation anormale sur une période courte | Revue fonctionnelle immédiate |
Je trouve utile de classer les seuils par niveau de gravité. Un premier niveau peut déclencher une simple observation renforcée, un deuxième niveau une analyse approfondie, et un troisième niveau une action immédiate sur le modèle ou sur les flux de données. Cette gradation permet de ne pas surréagir tout en évitant l’inaction.
Les actions correctives que je privilégie
Quand une dérive est identifiée, je ne cherche pas d’abord à « réparer » le modèle à tout prix. Je commence par comprendre si le problème vient des données, du cadrage, de l’environnement ou de l’algorithme lui-même. Cette étape change tout. Beaucoup de corrections inutiles viennent d’un diagnostic trop rapide.
Dans la pratique, j’utilise plusieurs leviers. D’abord, je peux corriger la chaîne de données : filtrage des entrées défectueuses, enrichissement des sources, harmonisation des formats, correction des doublons ou des valeurs aberrantes. Ensuite, je peux ajuster la logique de décision : recalibrage des seuils, modification des règles de post-traitement, ou introduction d’un mode plus prudent pour les cas incertains. Enfin, je peux décider d’un réentraînement du modèle sur des données plus récentes et plus représentatives.
Je garde aussi en tête qu’une action corrective ne doit pas masquer le problème. Si une équipe compense une dérive par une série de rustines, elle finit souvent par accumuler une dette technique et organisationnelle. Mieux vaut documenter clairement ce qui a changé, pourquoi cela a changé, et quel effet la correction a produit sur les métriques et sur le métier.
- Réentraînement ciblé : utile lorsque les données réelles se sont durablement éloignées du jeu initial.
- Recalibrage des seuils : pertinent si le modèle reste valable mais que la décision doit être ajustée.
- Retour à une version précédente : parfois nécessaire si une mise à jour a introduit une régression majeure.
- Renforcement de la validation humaine : indispensable pour les cas sensibles ou les zones d’incertitude élevée.
- Correction des sources de données : souvent plus efficace que la modification du modèle lui-même.
Ce que je mets en place avant même la mise en production
Je pense qu’une bonne surveillance se prépare avant le lancement. J’aime définir un référentiel de départ, avec des données de base, des valeurs attendues, des exemples de cas normaux et des cas limites. Cela permet de comparer les observations réelles avec une photographie initiale fiable. Sans cette base, il devient très difficile de distinguer une fluctuation acceptable d’une vraie dérive.
Je recommande également de prévoir un dispositif de traçabilité. Chaque version du modèle, chaque jeu de données, chaque paramètre important et chaque intervention doivent être consignés. Lorsque survient un incident, cette mémoire technique fait gagner un temps précieux. Elle permet de remonter plus vite à la cause racine et d’éviter les suppositions approximatives.
Enfin, je veille à ce que les équipes sachent quoi faire lorsqu’une alerte se déclenche. Une alerte sans procédure claire est presque inutile. Il faut savoir qui examine le signal, qui arbitre une mise en pause éventuelle, qui valide une correction et qui informe les parties prenantes. J’ai vu trop de systèmes bien conçus techniquement mais mal préparés sur le plan opérationnel.
Les erreurs que j’essaie d’éviter
La première erreur, à mon sens, consiste à croire qu’un modèle « appris » ne change plus. En réalité, il vit dans un environnement mouvant. La seconde erreur consiste à multiplier les métriques sans hiérarchie. Trop de données de surveillance noient les signaux importants. La troisième erreur consiste à traiter la surveillance comme une tâche purement technique. Un modèle d’IA n’est pas seulement un objet statistique ; c’est un composant inscrit dans une chaîne de valeur, avec des usages, des risques et des attentes.
J’évite aussi de laisser la surveillance reposer sur une seule personne. Une organisation robuste répartit les rôles entre celles et ceux qui comprennent le modèle, celles et ceux qui comprennent le produit et celles et ceux qui comprennent le contexte métier. Cette diversité de lecture est souvent ce qui permet de repérer plus tôt une dérive significative.
Au fil des projets, je me rends compte qu’une surveillance efficace est moins une question d’outillage que de discipline collective. Les bons indicateurs, les bons seuils et les bonnes actions ne suffisent pas si personne ne les consulte réellement, si les alertes ne sont pas prises au sérieux ou si les retours terrain ne sont pas intégrés dans la boucle d’amélioration. C’est dans cette articulation entre technique, gouvernance et usage que se joue, selon moi, la fiabilité durable d’un modèle d’IA en production.