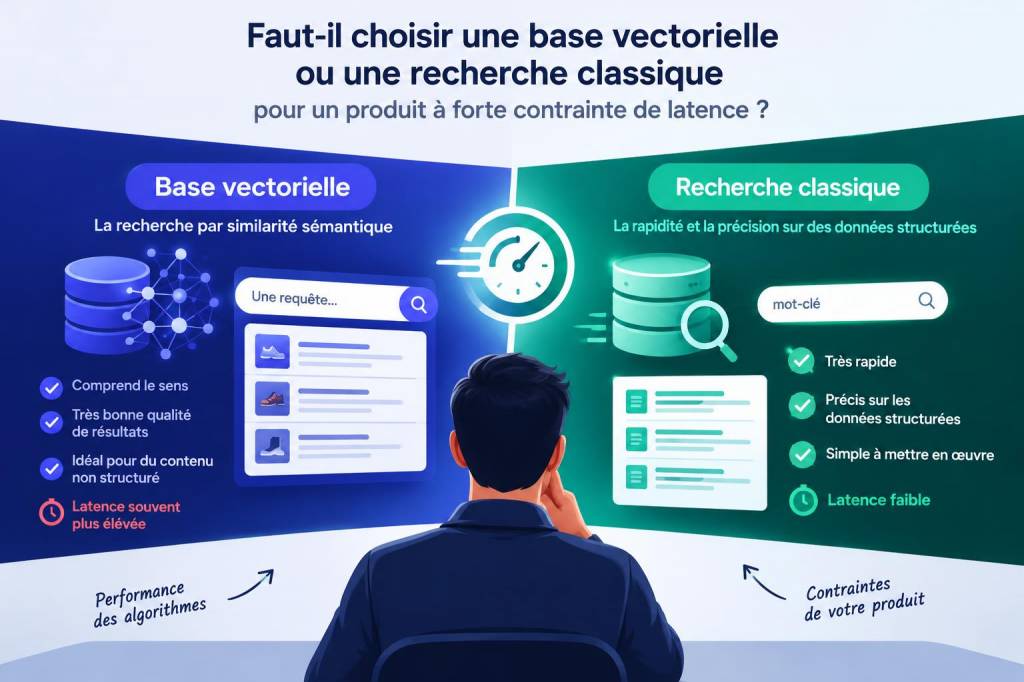
Quand je dois arbitrer entre une base vectorielle et une recherche classique pour un produit soumis à une forte contrainte de latence, je commence presque toujours par une question simple : que cherche-t-on réellement à optimiser ? La rapidité pure, la qualité des résultats, la souplesse sémantique, la simplicité d’exploitation, ou un équilibre entre tout cela ? Dans beaucoup d’équipes, on présente trop vite la base vectorielle comme une réponse moderne à tous les besoins de recherche. En réalité, le choix dépend surtout de la nature des données, du volume, du comportement attendu des utilisateurs et du niveau de précision indispensable.
Je vois encore trop souvent des projets qui remplacent une recherche classique par une base vectorielle sans avoir mesuré ce qu’ils gagnent, ni ce qu’ils perdent. Or, lorsqu’un produit doit répondre en quelques millisecondes, chaque couche supplémentaire compte : préparation des données, calcul des vecteurs, indexation, filtration, réseau, sérialisation, orchestration. Une architecture séduisante sur le papier peut devenir pénalisante si elle ajoute de la complexité là où un moteur classique, bien réglé, faisait déjà très bien le travail.
Ce que j’entends par recherche classique
Quand je parle de recherche classique, je pense à des approches fondées sur des index textuels, des correspondances exactes ou partielles, des tris, des filtres structurés et des requêtes déterministes. On y retrouve les moteurs capables de rechercher des mots, des expressions, des champs et des attributs avec une très grande efficacité. Dans un catalogue produit, un annuaire, un système de tickets ou un espace documentaire bien structuré, cette approche reste souvent la plus robuste.
Son grand avantage, c’est sa prévisibilité. Si je demande un identifiant précis, une référence, un statut, une date ou une combinaison de critères bien définis, je sais presque toujours à quoi m’attendre. La latence est généralement faible, les résultats sont explicables, et l’exploitation est plus facile à raisonner. J’apprécie beaucoup cette sobriété lorsqu’un produit doit garantir des temps de réponse constants.
En revanche, la recherche classique montre ses limites dès que l’intention de l’utilisateur dépasse la simple correspondance lexicale. Si une personne cherche « ordinateur léger pour voyage », alors que les fiches parlent de « portable ultracompact », le moteur classique risque de passer à côté, sauf si l’on a beaucoup travaillé le vocabulaire, les synonymes, les règles linguistiques et la qualité de la taxonomie.
Ce que la base vectorielle apporte réellement
La base vectorielle devient intéressante lorsque je veux rapprocher des éléments par signification plutôt que par simple ressemblance de mots. On transforme alors un contenu, une question, une image ou un profil en représentation numérique dense, puis on recherche les objets les plus proches dans cet espace. Cette approche ouvre des usages très puissants : recherche sémantique, recommandation, mise en relation de contenus, détection de doublons proches, assistance conversationnelle ou classement intelligent de résultats.
Je l’utilise volontiers lorsqu’un produit doit comprendre l’intention, la reformulation et le contexte. Par exemple, dans une base de connaissances, un utilisateur peut poser une question imprécise mais néanmoins pertinente. Une recherche vectorielle peut retrouver la bonne réponse même si les mots exacts ne sont pas présents. C’est particulièrement utile quand les contenus sont hétérogènes, multilingues, ou quand les utilisateurs ne connaissent pas le vocabulaire interne du produit.
Mais il faut être honnête : la base vectorielle ne fait pas de miracle. Elle introduit ses propres contraintes. Elle dépend de la qualité des vecteurs, du modèle utilisé pour les produire, de l’actualité de l’index, du réglage des seuils de similarité et de la manière dont on combine cette recherche avec des filtres métiers. Une mauvaise représentation peut donner des résultats surprenants, parfois très bons, parfois très décevants.
La latence change tout dans la décision
Dans un produit à forte contrainte de latence, je regarde d’abord le chemin complet de la requête. Si la réponse attendue doit arriver en moins de cinquante millisecondes, il faut être particulièrement attentif. Une recherche classique bien indexée, sur des données déjà structurées et hébergée à proximité du service applicatif, peut offrir une latence très stable. Une base vectorielle, elle, peut rester rapide, mais elle ajoute souvent davantage de variance, surtout si l’infrastructure est répartie, si le volume est élevé, ou si l’on combine similarité vectorielle et filtres complexes.
J’ai souvent constaté qu’un produit de recherche efficace n’est pas celui qui utilise la technologie la plus impressionnante, mais celui qui réduit le nombre d’étapes inutiles. Si la requête doit passer par un calcul de vecteur à la volée, puis par une recherche approximative, puis par un reclassement, il faut s’assurer que cette chaîne reste compatible avec l’expérience attendue. À l’inverse, si l’on peut pré-calculer les vecteurs, simplifier l’index et limiter les allers-retours, la base vectorielle devient beaucoup plus crédible.
Le problème n’est donc pas seulement la vitesse moyenne. C’est aussi la stabilité. Un produit rapide mais irrégulier crée une mauvaise perception. L’utilisateur ne retient pas la moyenne des temps de réponse, il retient les ralentissements visibles. C’est là que je préfère parfois une solution classique, moins spectaculaire mais plus régulière.
Les critères que j’utilise pour trancher
| Critère | Recherche classique | Base vectorielle |
|---|---|---|
| Latence prévisible | Très bonne | Bonne à moyenne selon l’architecture |
| Correspondance exacte | Excellente | Moins naturelle |
| Recherche sémantique | Limitée sans travail supplémentaire | Excellente |
| Explicabilité | Forte | Plus délicate |
| Complexité d’exploitation | Modérée | Plus élevée |
| Recherche sur filtres structurés | Très bonne | Bonne si l’architecture est bien pensée |
Au-delà de ce tableau, je regarde toujours cinq points concrets :
- la nature des requêtes les plus fréquentes ;
- le niveau d’ambiguïté des données ;
- le délai maximal acceptable par l’utilisateur ;
- la capacité de l’équipe à exploiter l’infrastructure ;
- la nécessité ou non d’une compréhension sémantique.
Si la majorité des requêtes sont exactes, structurées et répétitives, la recherche classique gagne souvent. Si les requêtes sont ouvertes, imprécises, contextuelles ou formulées de mille façons différentes, la base vectorielle devient plus pertinente.
Les cas où je garde la recherche classique sans hésiter
Je conserve volontiers une recherche classique lorsque le produit repose sur des identifiants précis, des filtres réglementaires, des listes courtes, des opérations financières ou des parcours où l’erreur n’est pas permise. Dans ces cas-là, la robustesse et la lisibilité priment sur l’intelligence sémantique.
Je la garde aussi lorsque l’équipe doit aller vite sans multiplier les dépendances techniques. Une recherche classique s’intègre souvent plus simplement dans une architecture existante, demande moins de réglages spécialisés, et facilite la mise au point. Pour un produit en phase de lancement, cela peut faire une énorme différence.
Enfin, je la privilégie quand la volumétrie est raisonnable et que les besoins métier sont bien cadrés. Inutile d’introduire une couche vectorielle si les utilisateurs cherchent essentiellement des références, des noms, des catégories ou des champs clairement définis.
Les cas où la base vectorielle devient un vrai avantage
Je bascule plus volontiers vers une base vectorielle lorsque le produit doit gérer du contenu non structuré, des descriptions riches, des questions libres, des documents longs, des profils variés ou des recommandations fondées sur la proximité de sens. C’est aussi pertinent dans les systèmes d’aide à la recherche interne, les interfaces conversationnelles et les moteurs de découverte de contenus.
Dans un environnement où les utilisateurs ne formulent pas toujours leurs besoins avec précision, la base vectorielle peut améliorer nettement la qualité perçue. Elle permet d’aller au-delà du mot-clé. Elle capte mieux les reformulations, les implicites et les relations conceptuelles. Sur certains produits, ce gain d’expérience utilisateur vaut largement la complexité supplémentaire.
Je trouve aussi qu’elle prend tout son sens lorsqu’elle est associée à une première recherche classique, puis à un reclassement sémantique. Cette approche hybride permet de conserver la rapidité et la précision des filtres tout en ajoutant une couche d’intelligence sur le classement final.
Ce que je recommande dans la pratique
Dans les produits à forte contrainte de latence, je recommande rarement un choix binaire. Je préfère penser en couches. La recherche classique peut servir de premier tri rapide, la base vectorielle peut enrichir la pertinence, et un reclassement final peut arbitrer entre précision métier et proximité sémantique. C’est souvent cette combinaison qui donne les meilleurs résultats.
Je conseille aussi de mesurer très tôt. Il ne suffit pas d’estimer. Il faut tester avec de vraies requêtes, de vrais volumes et de vrais scénarios d’usage. J’aime comparer trois indicateurs : le temps de réponse, la qualité des résultats et la stabilité dans la durée. Sans cela, on risque de choisir une technologie séduisante mais mal adaptée au terrain.
Voici, dans l’ordre, la logique que j’applique souvent :
- je définis le besoin métier réel ;
- j’identifie les requêtes déterministes et les requêtes ambiguës ;
- je mesure la latence cible et la tolérance des utilisateurs ;
- je vérifie la complexité d’exploitation acceptable ;
- je décide si une architecture hybride s’impose.
Dans certains produits, une base vectorielle seule est justifiée. Dans d’autres, la recherche classique reste imbattable. Et dans beaucoup de cas, la meilleure réponse n’est ni l’une ni l’autre isolément, mais une articulation intelligente entre les deux, avec des règles claires sur ce qui doit être rapide, explicable et maintenable. C’est là que je trouve le plus de valeur : non pas dans le choix d’un camp, mais dans la conception d’un système de recherche qui respecte à la fois l’utilisateur, l’équipe et les contraintes de temps.