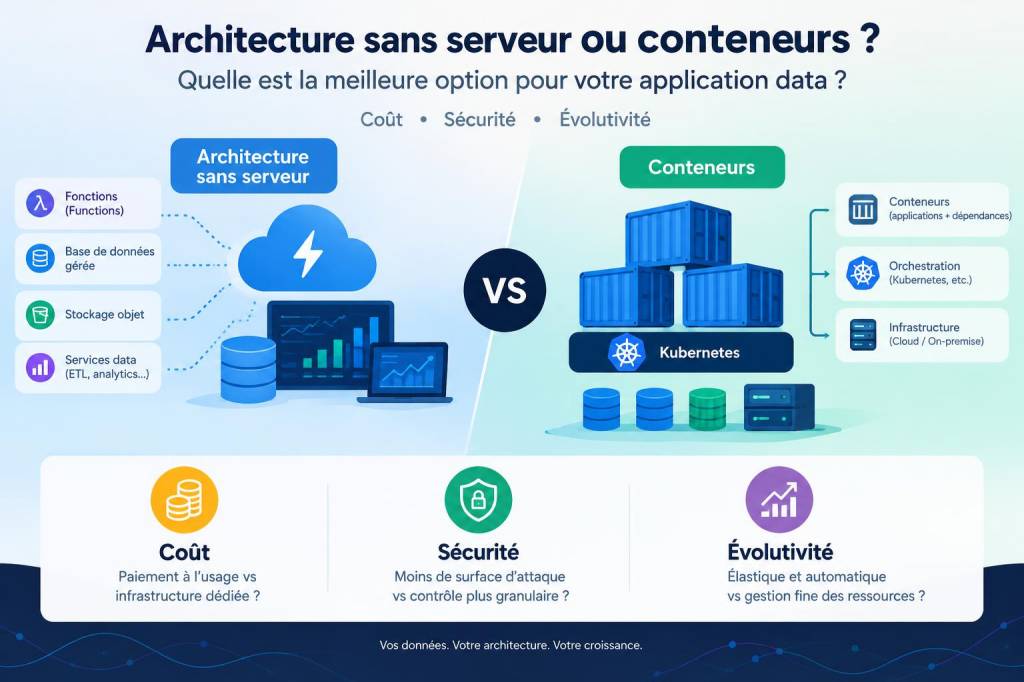
Quand je dois choisir une architecture pour une application de données, je ne pars jamais d’un simple effet de mode. Je pars d’un usage réel, d’une contrainte budgétaire, d’un niveau d’exposition acceptable et d’une ambition de croissance. Entre une architecture sans serveur et des conteneurs, il n’existe pas de réponse universelle. Il existe en revanche des contextes où l’une s’impose presque naturellement, et d’autres où le bon choix dépend d’un équilibre subtil entre coût, sécurité et évolutivité.
J’ai vu trop d’équipes partir sur une solution parce qu’elle semblait plus moderne, puis découvrir plus tard qu’elle compliquait l’exploitation, les tests ou la maîtrise des dépenses. À l’inverse, j’ai aussi vu des architectures trop rigides freiner des produits prometteurs. Pour une application data, la question est encore plus sensible, car les flux sont souvent variables, les traitements parfois lourds, et les exigences de confidentialité souvent élevées.
Ce que je mets derrière une architecture sans serveur
Quand je parle d’architecture sans serveur, je parle d’un modèle où je ne gère pas directement de machines à administrer. Les fonctions s’exécutent à la demande, selon un événement ou une requête, et l’infrastructure est masquée autant que possible. Ce modèle convient très bien à des traitements ponctuels, à des tâches déclenchées par des événements, à des interfaces de programmation légères ou à des chaînes de traitement qui montent et descendent vite en charge.
Sur une application data, j’aime cette approche lorsqu’il faut ingérer des données par lots, transformer des fichiers à la réception, déclencher des contrôles de qualité ou exécuter des calculs isolés. Je la trouve particulièrement pertinente quand l’activité est irrégulière. Si l’usage est intermittent, pourquoi maintenir des ressources allumées en permanence ?
Mais cette simplicité apparente a un revers. Dès que la logique applicative s’épaissit, dès que les dépendances se multiplient ou que les temps d’exécution s’allongent, la lecture du système devient plus délicate. Je dois alors surveiller de près la fragmentation des fonctions, la traçabilité des échanges et les limites imposées par le fournisseur.
Ce que j’attends des conteneurs
Les conteneurs me donnent un autre niveau de contrôle. J’y vois une manière d’empaqueter l’application avec ses dépendances, de la rendre plus portable et de mieux maîtriser l’environnement d’exécution. Pour une application data, c’est souvent très utile lorsque le traitement est continu, lorsque les composants sont nombreux ou lorsque j’ai besoin d’une architecture plus stable dans le temps.
J’apprécie les conteneurs quand je dois faire tourner un service d’ingestion permanent, une file de traitement, une interface d’analyse ou un composant qui demande une configuration précise. Ils sont souvent plus adaptés aux chaînes où les traitements sont longs, répétés et relativement prévisibles. Je trouve aussi qu’ils facilitent certaines pratiques d’ingénierie, notamment lorsque les équipes veulent rapprocher développement, essais et mise en production sans modifier profondément leur environnement.
En revanche, les conteneurs demandent davantage de discipline. Il faut penser orchestration, surveillance, mise à l’échelle, sécurité des images, mises à jour régulières et supervision. On gagne en maîtrise, mais on perd une part de simplicité opérationnelle. Pour moi, la vraie question est donc la suivante : ai-je besoin d’un contrôle fin, ou ai-je besoin d’une exécution la plus simple possible ?
Le coût réel ne se limite jamais à la facture mensuelle
Quand les équipes me parlent de coût, elles pensent d’abord au prix affiché par le fournisseur. Je les comprends, mais je préfère raisonner en coût global. Une architecture sans serveur peut paraître très économique au départ, surtout si la charge est irrégulière. On paie surtout à l’usage. Cela peut être redoutablement efficace pour des flux variables, car je n’entretiens pas de capacité inutilisée.
Mais ce modèle peut devenir moins avantageux si les appels sont très fréquents, si les traitements sont nombreux ou si les temps d’exécution s’allongent. Dans ce cas, l’addition peut grimper vite. Il faut aussi intégrer le coût de la complexité : surveillance des journaux, gestion des dépendances, découpage de la logique, intégration de plusieurs services.
Les conteneurs, eux, offrent souvent une structure de dépense plus lisible, surtout lorsque l’activité est soutenue et continue. Je peux mieux prévoir mes besoins en ressources, dimensionner mes serveurs et optimiser mes charges de travail. En contrepartie, je paie davantage le temps d’inactivité si l’infrastructure reste allumée en permanence. Dans mon expérience, les conteneurs deviennent souvent plus intéressants lorsque l’application traite beaucoup de données, de façon régulière, et que les équipes savent optimiser l’occupation des ressources.
Je regarde aussi les coûts cachés : temps d’exploitation, temps de dépannage, temps passé à sécuriser et à documenter. Une solution techniquement élégante peut devenir très chère si elle mobilise trop d’attention humaine.
| Critère | Architecture sans serveur | Conteneurs |
|---|---|---|
| Charge variable | Souvent très avantageuse | Possible, mais parfois moins optimisée |
| Charge continue | Peut devenir coûteuse | Souvent mieux adaptée |
| Gestion opérationnelle | Allégée | Plus exigeante |
| Prévisibilité budgétaire | Parfois plus difficile à anticiper | Souvent meilleure |
| Temps d’exploitation | Réduit | Plus important |
La sécurité n’est pas la même selon le modèle
Sur le plan de la sécurité, j’ai appris à ne jamais opposer simplicité et protection comme si l’une excluait l’autre. Une architecture sans serveur bénéficie souvent d’un cadre de sécurité bien intégré par le fournisseur, ce qui peut rassurer au départ. Les droits sont ciblés, les surfaces exposées sont plus limitées et l’infrastructure sous-jacente est moins visible pour l’équipe.
Mais la sécurité ne se résume pas à l’infrastructure. Dans une architecture sans serveur, je dois être attentive à la gestion des permissions, à la chaîne d’événements, aux entrées mal formées et à la multiplication des petits composants. Une fonction mal configurée peut ouvrir une brèche, surtout si les échanges entre services sont mal maîtrisés. Je me méfie particulièrement des autorisations trop larges et des journaux insuffisants.
Avec les conteneurs, la responsabilité est plus directe. Je dois sécuriser les images, limiter les privilèges, surveiller les dépendances, durcir l’exécution et organiser les correctifs. Cela demande une rigueur plus forte, mais cela donne aussi davantage de maîtrise. Pour des données sensibles, j’apprécie cette maîtrise, à condition que l’équipe ait la maturité nécessaire. Un conteneur mal maintenu peut devenir un point faible sérieux, surtout si les mises à jour sont négligées.
Pour une application data, je regarde aussi la nature des données traitées. Si je manipule des données personnelles, des informations financières ou des jeux de données stratégiques, je veux savoir où elles transitent, qui y accède et comment elles sont journalisées. Dans certains cas, les conteneurs me semblent plus rassurants parce que j’y impose plus facilement mes propres règles de cloisonnement. Dans d’autres cas, la simplicité d’une architecture sans serveur réduit le nombre de points d’entrée à protéger.
L’évolutivité dépend du rythme de croissance, pas seulement du volume
Beaucoup de personnes associent l’évolutivité à la seule capacité d’absorber plus de trafic. Pour moi, c’est plus large. Une application est évolutive si elle peut absorber plus de charge, mais aussi si elle peut changer sans se casser. C’est ici que le choix entre architecture sans serveur et conteneurs devient vraiment intéressant.
L’architecture sans serveur excelle souvent lorsque les montées en charge sont soudaines et imprévisibles. Je l’aime pour des pointes, pour des traitements déclenchés par événements et pour des usages où le nombre d’exécutions varie fortement. Elle permet d’avaler beaucoup de sollicitations sans que je planifie moi-même une grande réserve de capacité.
Les conteneurs, eux, me donnent davantage de souplesse architecturale lorsque l’application grandit en complexité. Je peux séparer les services, mieux organiser les dépendances, ajuster les ressources par composant et faire évoluer une partie du système sans tout réécrire. Pour une plateforme data appelée à se structurer dans le temps, c’est un atout majeur.
Je fais souvent ce constat : si le besoin principal est d’absorber un flux irrégulier, j’oriente volontiers vers le sans serveur. Si le besoin principal est de bâtir une plateforme durable, riche en traitements et en composants, les conteneurs prennent souvent l’avantage. L’évolutivité n’est pas qu’une affaire de puissance ; c’est aussi une affaire de gouvernance technique.
Les critères que j’utilise avant de trancher
Quand je dois conseiller une équipe, je commence par quelques questions simples, mais décisives :
- La charge est-elle régulière ou très fluctuante ?
- Les traitements sont-ils courts ou longs ?
- L’équipe dispose-t-elle d’une forte maturité d’exploitation ?
- Les données traitées exigent-elles un cloisonnement strict ?
- Le budget doit-il rester très prévisible ?
- L’application risque-t-elle de changer souvent de forme ?
Si plusieurs réponses pointent vers la simplicité, la variabilité et la rapidité de mise en œuvre, l’architecture sans serveur mérite une vraie attention. Si les réponses pointent vers la maîtrise, la stabilité, la personnalisation et la croissance continue, les conteneurs deviennent plus crédibles.
Je regarde aussi la composition de l’équipe. Une petite équipe très concentrée sur la valeur métier peut préférer déléguer une partie de l’exploitation à une architecture sans serveur. Une équipe plateforme plus expérimentée peut au contraire tirer beaucoup de valeur d’un environnement conteneurisé, surtout si elle veut standardiser ses déploiements et garder la main sur les performances.
Mon approche dans les projets de données
Dans la pratique, je privilégie souvent une lecture hybride. Il n’est pas rare qu’une application data combine plusieurs modes d’exécution : des fonctions sans serveur pour l’ingestion événementielle, des conteneurs pour les traitements plus lourds, et parfois même une répartition par étapes selon le type de charge. Cette combinaison me paraît souvent plus réaliste qu’un choix tranché dès le départ.
Je vois aussi beaucoup de valeur dans les phases de test rapide. Pour une première version, une architecture sans serveur permet parfois d’aller vite, de valider un besoin et de mesurer les volumes réels. Ensuite, si la croissance s’installe, je peux faire évoluer certains composants vers des conteneurs sans remettre en cause l’ensemble du système. À l’inverse, une base conteneurisée peut accueillir progressivement des fonctions sans serveur pour absorber des pics ponctuels ou simplifier certaines tâches périphériques.
Ce que je cherche avant tout, ce n’est pas la perfection abstraite. C’est la cohérence entre l’outil, l’équipe et l’usage. Une architecture réussie est celle qui aide le produit à vivre, à se sécuriser et à grandir sans alourdir inutilement la machine.