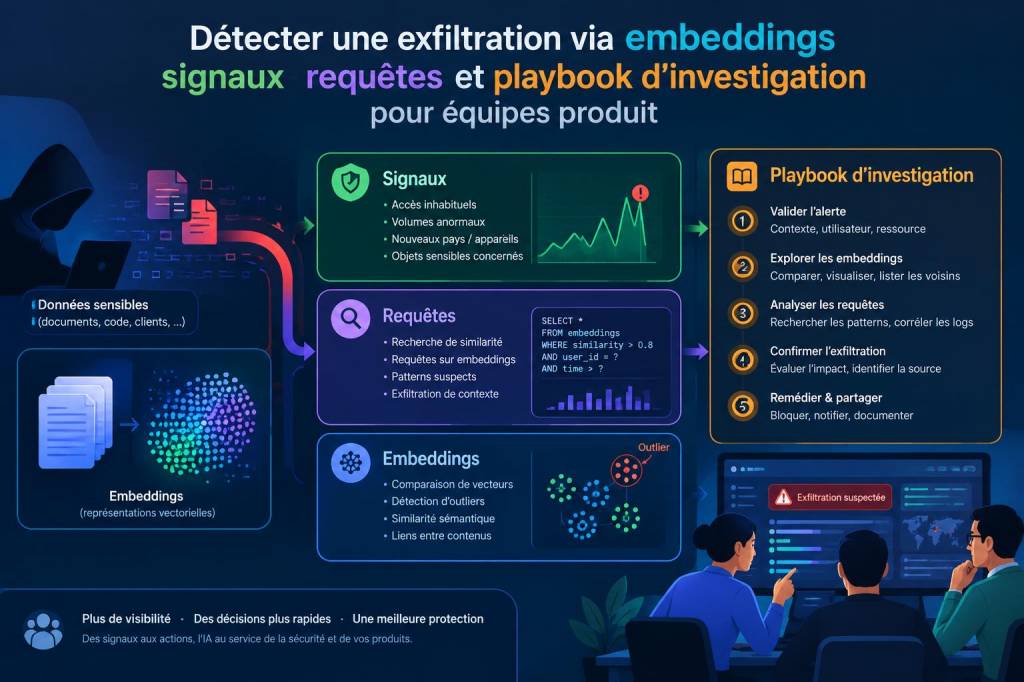
Les embeddings sont entrés dans nos produits comme une brique presque magique : meilleure recherche sémantique, recommandations plus fines, clustering de documents, et bien sûr pipelines d'IA. Mais cette promesse s'accompagne d'un risque concret et parfois sous-estimé : l'exfiltration de données via des vecteurs d'embeddings. J'écris ici à destination des équipes produit et sécurité — avec des retours pratiques, des signaux d'alerte et un playbook d'investigation que j'applique quand je dois auditer ou répondre à un incident lié aux embeddings.
Pourquoi les embeddings facilitent l'exfiltration
Les embeddings transforment du texte ou des documents en vecteurs numériques. Ces vecteurs représentent l'information de manière condensée : ils conservent des similarités sémantiques et peuvent être comparés rapidement. C'est précisément ce format qui peut être abusé pour extraire ou reconstruire des données sensibles.
Deux mécanismes principaux rendent les embeddings dangereux :
les systèmes de recherche sémantique qui révèlent des similitudes entre une requête et des documents confidentiels ;les APIs d'embeddings ou de similarité qui renvoient des voisins proches (nearest neighbors) ou des scores permettant à un attaquant d'inférer le contenu d'un document.Scénarios d'exfiltration que j'ai observés
Dans mes audits, j'ai rencontré plusieurs schémas récurrents :
Attaques par probing : un attaquant envoie des centaines ou milliers de requêtes conçues pour identifier si une base contient des documents liés à un secret (ex. numéros de carte, PII, code source).Reconstruction incrémentale : en combinant des requêtes de similarité et des feedbacks (scores, positions, snippets), un attaquant reconstitue progressivement le contenu d'un document.Poisoning / data leakage latent : des données sensibles se retrouvent indexées dans un store d'embeddings accessible, puis exploitées via la recherche sémantique par un acteur légitime ou malveillant.Signaux techniques à surveiller
Voici les signaux qui, selon moi, méritent une attention immédiate dans vos logs et outils de monitoring :
Volume anormal de requêtes embeddings — pics d'appels depuis une même clé API, un même utilisateur ou une même IP. Les embeddings sont coûteux ; une rafale d'appels est souvent suspecte.Requêtes répétitives et structurées — variantes systématiques d'une même requête (ex. "Trouve tous les documents contenant 'numéro' + X").Utilisation de tokens ou prompts ciblés — mots-clés sensibles (SSN, carte bancaire, "confidentiel", noms de projets internes) fréquemment présents dans les requêtes.Patterns de similarité élevés — recherche de voisins très proches (distance cosinus > 0.95) sur des documents classés comme sensibles.Abonnements ou comptes récemment créés effectuant des requêtes volumineuses ou exploratoires.Résultats de recherche anormaux — extraction de snippets ou métadonnées associées à des voisins éloquents (par ex. des extraits de code, coordonnées).Exemples de requêtes suspectes
Pour être concret, voici quelques patterns de requêtes ou prompts que j'ai vus dans des incidents :
“Donne-moi les documents contenant ‘private_key’ ou ‘API_KEY’”“Quels fichiers font référence à ‘confidential-project-X’ ?”Envoi d'un token unique suivi de variations : “Trouve la ligne contenant ‘ABC123’”, “Trouve la ligne contenant ‘ABC124’”…Requêtes successives de similarité avec perturbations : “Quelle phrase est la plus proche de ‘mot-clé A’ ?” puis “la plus proche de ‘mot-clé B’ ?” — méthode de triangulation pour reconstruire le document.Comment détecter automatiquement ces comportements
La détection combine rules-based et apprentissage. Voici les approches que je recommande :
Baselines et détections d'anomalie : mesurer le comportement normal par utilisateur/tenant (taux de requêtes embeddings, distribution de similarités, longueur moyenne des prompts). Déclencher alertes au-delà de seuils statistiques (3-4 sigma).Filtrage lexical et scoring de sensibilité : scanner les prompts à la recherche de mots-clés sensibles et appliquer un score. Un prompt long + score élevé = alerte prioritaire.Fingerprinting de requêtes : créer des signatures pour les patterns répétitifs (variations de mots, mêmes endpoints) et regrouper par hash pour identifier probing.Monitoring des voisins retournés : alerter si des voisins fréquemment retournés appartiennent à des documents marqués sensibles.Rate-limiting adaptatif : appliquer throttling progressif quand un comportement ressemble à de l'exploration.Playbook d'investigation pour équipes produit
Quand une alerte survient, voici la séquence que je suis (et que je conseille d'opérationnaliser) :
Triage initial — collecter logs : timestamp, clé API, user-id, IP, payloads (prompts), endpoints, résultats (id des vectors renvoyés, scores). Déterminer si la requête est interne (bot, crawler) ou externe.Confinement immédiat — si la requête provient d'une clé compromise : révoquer la clé, mettre en quarantaine le compte, activer rate limiting global si nécessaire.Analyse des patterns — reconstruire la série temporelle des requêtes pour identifier probing, séquences de triangulation, ou exfiltration brute-force.Recherche inverse sur embeddings — pour les voisins retournés, vérifier les documents sources, leur classification de sensibilité et l'historique d'accès. Utiliser des outils comme FAISS, Milvus ou Pinecone pour corréler les hits.Reconstruction de l'impact — quelle donnée a potentiellement été extraite ? PII, code, secrets ? Estimation du périmètre et des utilisateurs affectés.Remédiation — retirer les documents sensibles du store d'embeddings, ré-encoder après nettoyage, appliquer masking ou chiffrement à la volée, mettre à jour les policies d'access.Communication — notifier parties prenantes internes et, si applicable, légal/regulatory. Documenter les actions et les preuves.Prévention — déployer règles de détection supplémentaires, rotation de clés, tests d'injection/attaque (red-team embeddings), revues périodiques.Tableau des indicateurs et actions recommandées
| Indicateur | Seuil / Exemples | Action immédiate |
| Pic d'appels embeddings | +500% du baseline par clé en 24h | Révoquer clé, quarantaine compte, analyser payloads |
| Prompts sensibles | Présence de mots-clés (SSN, private_key) | Bloquer prompt, alerter sécurité |
| Requêtes répétitives et variantes | +50 requêtes avec structure identique | Limiter taux, capturer séquence |
| Voisins très proches | Distance cosinus > 0.95 sur docs marqués sensibles | Prioriser investigation, retirer doc si nécessaire |
Bonnes pratiques produit que j'applique systématiquement
Pour limiter le risque en amont, je recommande ces mesures pragmatiques :
Indexer uniquement les métadonnées et excerpts nécessaires — éviter d'indexer des blocs entiers de documents sensibles.Appliquer du masking ou du tokenisation pour les champs sensibles avant génération d'embeddings.Mettre en place des policies d'accès fines (RBAC) pour les endpoints d'embeddings et rechercher un modèle "least privilege".Logger de manière structurée (JSON) prompts, réponses, scores et ids; garder les logs suffisants pour reconstructibilité.Tester régulièrement avec des scénarios d'attaque (probing, triangulation) pour valider vos règles de détection et seuils.Je suis convaincue que la prévention et la détection des exfiltrations via embeddings ne relèvent pas que de la sécurité mais aussi du design produit. En construisant des APIs qui minimisent l'exposition des vecteurs et en dotant les équipes d'outils d'observation adaptés, on peut offrir la puissance des embeddings sans sacrifier la confidentialité.