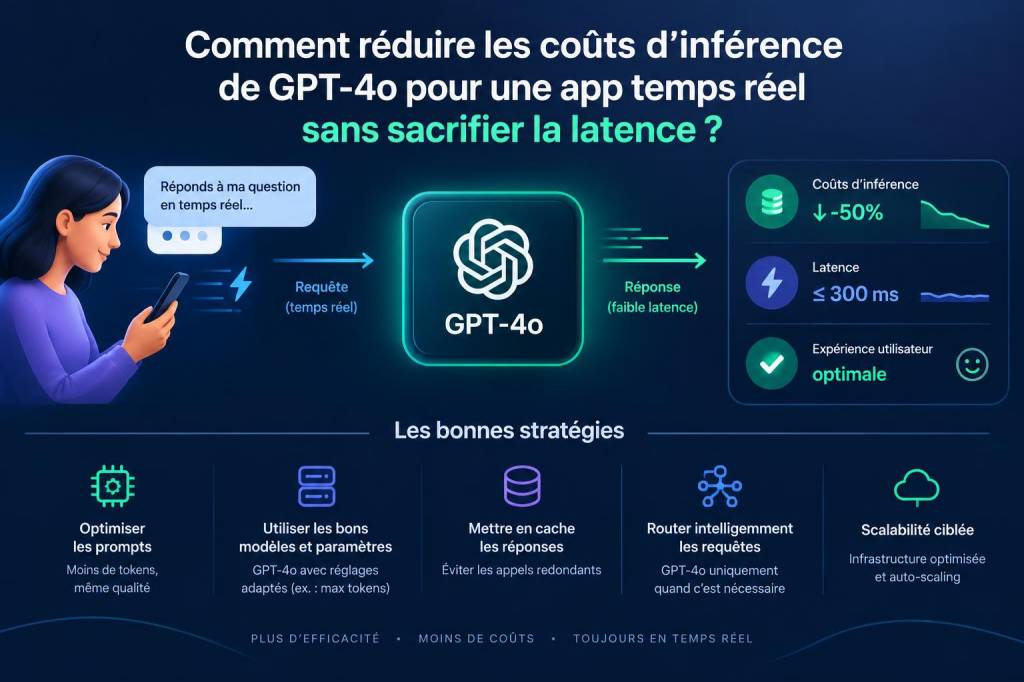
Sur Nexpod, j'écris souvent sur les compromis techniques et économiques que pose l'intégration de l'IA dans des produits réels. Récemment, plusieurs fondateurs et équipes produit m'ont demandé : comment réduire la facture d'inférence de GPT-4o dans une application temps réel sans sacrifier la latence ? J'ai accompagné des équipes sur ce sujet et testé des approches en production. Voici un guide pratique, tiré de retours d'expérience concrets, pour garder des réponses rapides tout en maîtrisant les coûts.
Comprendre d'où vient le coût
Avant d'optimiser, il faut savoir ce qui coûte. Pour des modèles comme GPT-4o, les postes de coûts principaux sont :
- le coût par token (entrée + sortie) facturé par l'API (OpenAI ou concurrents) ;
- le coût d'infrastructure si vous faites de l'inférence sur vos propres GPU/serveurs (compute et mémoire) ;
- les coûts de stockage et de recherche liés au contexte (vector DB, index) ;
- les coûts opérationnels liés à la scalabilité et à la latence (autoscaling, monitoring, réseau).
Si votre application est "temps réel", la latence est souvent contraignante : vous ne pouvez pas simplement baisser la taille du modèle si la qualité utilisateur en souffre. Il faut donc combiner plusieurs leviers.
Optimisations côté prompt et contexte
J'insiste toujours sur le premier réflexe : réduire la quantité de tokens envoyés et reçus sans diminuer la qualité.
- Prompt engineering : synthétiser les instructions, utiliser des templates compressés (remplacer phrases longues par tokens-signaux), réutiliser des prompts prévalidés. Un prompt plus compact réduit directement la facture.
- Contexte dynamique : n'envoyez que les messages pertinents. Par exemple, pour un assistant conversationnel, limitez l'historique à l'essentiel (résumé + derniers échanges), plutôt que toute la conversation brute.
- Récapitulatif compressé : stockez un résumé actif (embeddings + texte résumé) et envoyez le résumé plutôt que tout l'historique. Cela fonctionne particulièrement bien si vous combinez avec une base de connaissances (RAG).
- Token-level pruning : remplacez des champs verbeux (meta, descriptions) par des identifiants ou par des embeddings récupérés côté serveur.
Architecture hybride : API gérée + modèles locaux
Une stratégie courante que j'aide à mettre en place est le routage hybride : utiliser un modèle léger en local/edge pour la plupart des requêtes et basculer vers GPT-4o pour les cas complexes.
- Exemples : héberger un Llama 2 quantifié, Mistral-7B ou un LLM optimisé pour l'inférence (à l'aide de packages comme GGML/ggml-quant), pour les tâches de classification, paraphrase ou réponses simples.
- Utiliser GPT-4o uniquement pour les prompts créatifs, multi-turn complexes ou quand la qualité dépasse le seuil du modèle local.
Ce pattern réduit massivement le nombre de requêtes facturées à OpenAI tout en gardant la latence basse pour la majorité des interactions.
Quantification, distillation et modèles spécialisés
Si vous opérez vos propres serveurs GPU :
- Quantification (int8/int4) : permet d'exécuter des modèles plus grands à moindre coût et avec moins de mémoire — et souvent avec une latence réduite. Outils : TensorRT, Intel OpenVINO, PyTorch quantization, Ollama/GGML.
- Distillation : entraîner une version plus petite d'un modèle pour reproduire son comportement sur vos cas d'usage. Il faut du travail en amont, mais le gain en production peut être important.
- Modèles spécialisés : pour des tâches précises (reformulation, extraction, classification), un modèle spécialisé plus petit offre souvent un meilleur ratio coût/latence.
Caching, pré-calcul et réponse progressive
Plusieurs optimisations simples mais puissantes :
- Cache en mémoire pour réponses fréquentes (Redis, Memcached) : beaucoup de requêtes sont répétitives — un bon cache sauve énormément.
- Pré-calcul des réponses attendues pour des scénarios prévisibles (ex : FAQ dynamiques).
- Streaming + partial responses : renvoyer une réponse partielle dès que disponible pour améliorer la perception de latence, puis compléter en arrière-plan. Cela ne réduit pas toujours les coûts, mais améliore l'expérience utilisateur sans augmenter le modèle.
Bacthing, déduplication et gestion des appels API
Pour les architectures backend :
- Batching : regrouper les requêtes courtes lorsque possible (par ex. traitements par lots en fin de cycle), pour profiter des économies d'échelle sur les modèles auto-hébergés.
- Déduplication : éviter d'appeler le modèle plusieurs fois pour la même intention (mettre en place un middleware de déduplication).
- Rate-limiting et priorisation : limiter les appels non essentiels à l'API coûtante pendant les pics et prioriser les requêtes utilisateur critiques.
RAG (Retrieval-Augmented Generation) : réduire la génération coûteuse
J'utilise souvent le RAG pour garder le contexte pertinent sans gonfler le prompt :
- Indexer les contenus fréquents dans un vector store (Pinecone, Weaviate, Milvus) ;
- Récupérer les passages pertinents, les résumer ou les envoyer en tant que contexte réduit ;
- Le modèle génère avec un contexte ciblé plutôt qu'avec un historique complet — moins de tokens, réponses plus factuelles.
Choisir le bon niveau d'infrastructure
Si vous hébergez :
- Distinguez inférence (GPU haute fréquence) et entraînement (GH/s). Pour l'inférence, des GPU comme les NVIDIA H100/A100 ou des solutions cloud dédiées (AWS Inferentia, GCP TPUs) peuvent réduire le coût par token.
- Considérez les instances spot ou réservées pour réduire les coûts d'hébergement non critiques.
- Si vous utilisez une API (OpenAI), comparez les modèles et plans : parfois un modèle "génératif" plus ancien pour des tâches simples est suffisant et beaucoup moins cher.
Surveiller, mesurer, itérer
Mes conseils opérationnels :
- Mettre en place un suivi fin (coût par endpoint, coût par utilisateur, tokens moyenne par request).
- Expérimenter A/B pour vérifier l'impact utilisateur quand on change de modèle/stratégie.
- Automatiser le routage (par exemple : classifier en amont la complexité du prompt et router vers modèle local vs GPT-4o).
| Approche | Réduction de coût | Impact latence | Complexité d'implémentation |
|---|---|---|---|
| Prompt / contexte optimisés | Moyen | Neutre | Faible |
| Cache & pré-calcul | Élevé pour requêtes répétitives | Améliore | Moyen |
| Modèle local quantifié | Élevé | Améliore | Élevé |
| Routage hybride (local vs GPT-4o) | Très élevé | Neutre à amélioration | Élevé |
| RAG | Moyen à élevé | Neutre | Moyen |
Enfin, un dernier point pratique : documentez et testez chaque optimisation. Certaines réductions de coût (ex : quantification agressive) peuvent introduire des régressions subtiles. Dans plusieurs projets, j'ai préféré une approche itérative : commencer par prompt+cache+RAG, puis ajouter un modèle local quantifié si le ratio coût/qualité était favorable.
Si vous le souhaitez, je peux examiner votre architecture actuelle (endpoints, volumes, patterns d'usage) et proposer un plan d'optimisations chiffré et priorisé. Sur Nexpod, j'aime transformer ces échanges en guides opérationnels — n'hésitez pas à partager un cas concret.