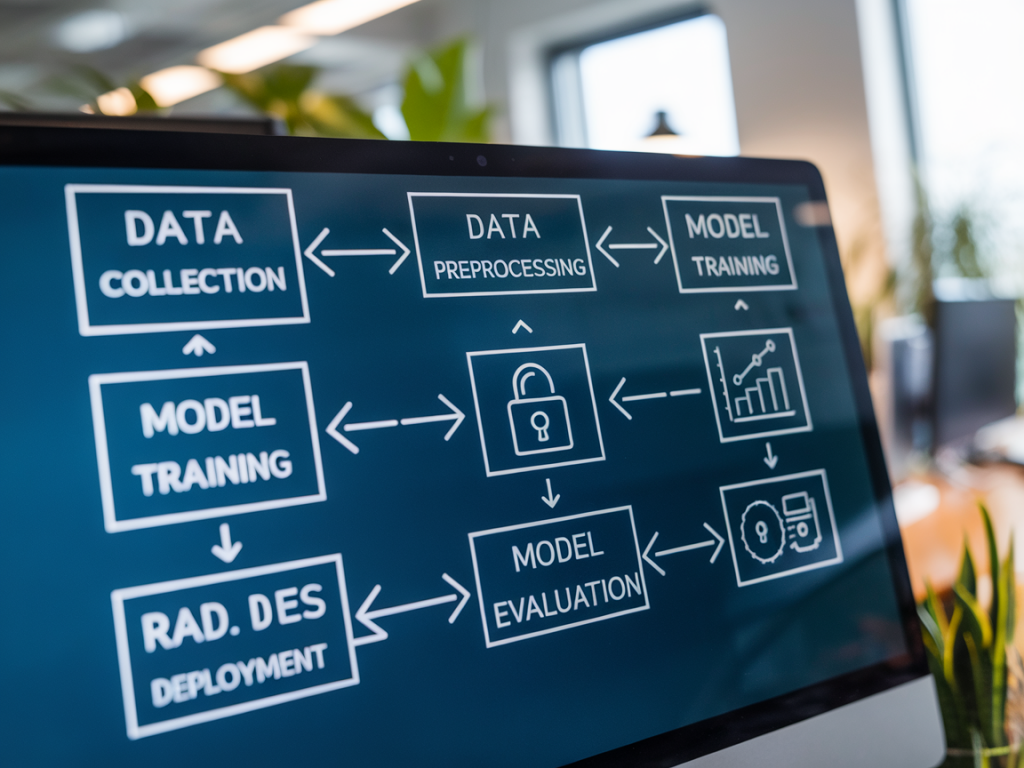
Auditer et chiffrer un pipeline de machine learning pour satisfaire le RGPD tout en réduisant la surface d'attaque n'est pas seulement une exigence réglementaire : c'est une approche pragmatique pour limiter les risques opérationnels et préserver la confiance. J'aborde ici une méthode concrète, tirée de mes accompagnements auprès d'équipes produit et d'équipes sécurité, pour transformer un pipeline ML opaque en un système mesurable, auditable et plus sûr.
Commencer par cartographier le pipeline et les flux de données
La première étape est toujours la cartographie. Sans schéma précis, on ne peut pas chiffrer ni protéger. Je trace le pipeline de bout en bout : collecte, ingestion, transformation, stockage, entraînement, validation, déploiement, monitoring, réentraînement. Pour chaque étape, je liste :
- les sources de données (internes, externes, APIs, logs)
- les types de données traitées (données personnelles, catégorisées sensibles, pseudonymisées, agrégées)
- les utilisateurs/services accédant aux données
- les composants techniques (bases, buckets S3, Kafka, Airflow, Kubernetes, modèles hébergés)
- les dépendances tierces (SDK, modèles pré-entraînés, services cloud)
Cette cartographie me permet de définir la provenance et le destin de chaque donnée, condition indispensable pour appliquer les principes du RGPD (minimisation, limitation de la finalité, conservation limitée).
Évaluer la conformité RGPD étape par étape
Pour chaque étape identifiée, j'applique un questionnaire RGPD simplifié :
- Quelle est la base légale du traitement ? (consentement, intérêt légitime, exécution d'un contrat...)
- Les données sont-elles nécessaires à la finalité ? Peut-on les minimiser ou pseudonymiser ?
- Où les données sont-elles stockées ? (pays, niveau de chiffrement)
- Combien de temps sont-elles conservées ? Existe-t-il une politique de purge automatique ?
- Les droits des personnes (accès, rectification, effacement) sont-ils applicables et techniquement réalisables ?
- Le transfert vers des tiers ou des sous-traitants est-il encadré par des contrats et garanties appropriées ?
Ce questionnaire donne une note de conformité par étape — une première estimation qualitative qui servira de base au chiffrage des risques.
Chiffrer la surface d'attaque : méthode et métriques
J'aime distinguer deux dimensions : exposition (quelles interfaces/chemins peuvent être exploités) et critically (quelle valeur ou sensibilité a la donnée ou le modèle). Quelques métriques opérationnelles que j'utilise :
- Nombre d'endpoints externes exposés (APIs, dashboards) : un indicateur simple d'exposition réseau.
- Nombre de comptes/service-accounts ayant accès en lecture/écriture aux données sensibles.
- Proportion de données non chiffrées au repos et en transit.
- Pourcentage de modèles entraînés avec données non pseudonymisées.
- Temps moyen de détection d'un incident (MTTD) et temps moyen de réponse (MTTR).
- Score d'attaque relatif : combinaison pondérée (exposition x criticité x facilité d'exploitation).
Par exemple, si un bucket S3 contient des données personnelles non chiffrées et est accessible via un rôle IAM partagé par plusieurs services, l'exposition et la criticité sont élevées — le score d'attaque augmente.
Cartographie des contrôles techniques et organisationnels
Pour réduire la surface d'attaque et améliorer la conformité, j'établis une matrice "contrôle ↔ risque" et priorise selon l'impact et la probabilité. Voici un extrait que j'applique souvent :
| Risque | Contrôle recommandé | Indicateur / Métrique |
|---|---|---|
| Exposition d'un stockage | Chiffrement côté serveur + chiffrement côté client pour données sensibles | % d'objets chiffrés, % accès non autorisés bloqués |
| Accès excessif par comptes machines | Principe de moindre privilège, IAM basé sur rôles, accès temporaires | Nombre de politiques IAM auditables, % comptes avec MFA |
| Fuite via modèles (membership inference) | Pseudonymisation, differential privacy, tests d'attaque en CI | Score d'exposition du modèle à attaques d'inférence |
| Transfert vers tiers non contrôlé | Contrats, DPA, audits des sous-traitants | % de fournisseurs évalués, SLA de sécurité |
Tests d'attaque et audit technique
Un audit ML doit inclure des tests techniques : pentest des endpoints, revue IaC (Terraform, Helm), scans de dépendances, et tests spécifiques aux modèles.
- Pentest API et UI (OWASP) : vérifier fuites d'API keys, endpoints non protégés.
- Audit IAM et secrets management : trouver les credentials hardcodés ou permissions suroctroyées.
- Revue des pipelines CI/CD : s'assurer que les artéfacts (données, checkpoints modèle) ne sont pas publiés par erreur.
- Attaques sur le modèle : membership inference, model inversion, poisoning — idéalement en environnement staging.
- Tests de réidentification : évaluer si des jeux de données pseudonymisés peuvent être ré-identifiés via recoupement.
Pour ces tests, j'utilise des outils comme Trivy/Checkov pour IaC, OWASP ZAP pour API, et des bibliothèques de privacy-testing comme SmartNoise ou le toolkit d'OpenDP pour simulations de privacy.
Mesurer pour décider : KPIs et reporting
Afin de prioriser les actions, je définis des KPIs clairs à reporter au management :
- Nombre de risques critiques ouverts liés à des traitements de données personnelles
- Couverture des logs et traçabilité (pourcentage d'événements liés aux données personnelles correctement journalisés)
- Temps de purge moyen pour données des users (conformité au retention policy)
- Résultats des tests d'attaque des modèles (score d'exposition)
- Taux d'utilisation de techniques de protection (pseudonymisation, DP, chiffrement)
Ces KPIs permettent d'avoir une conversation factuelle avec la DPO, le RSSI et la direction produit sur les investissements nécessaires.
Organiser la gouvernance et les responsabilités
Un pipeline ML sûr et conforme repose sur des rôles clairs. Je recommande :
- Un propriétaire de données (data owner) pour chaque catégorie de données
- Un responsable sécurité du pipeline (SRE/RSSI) en charge des contrôles d'accès et du monitoring
- La DPO pour la validation des bases légales et des réponses aux droits
- Des revues régulières (data protection impact assessment — DPIA) mises à jour à chaque modification significative
La DPIA n'est pas une formalité ; c'est le cœur de la justification RGPD pour un traitement ML. Je l'utilise comme document-vérité pour chiffrer les risques résiduels et décider des mesures compensatoires.
Automatiser l'audit et la réduction de surface
Enfin, il faut automatiser. J'intègre des contrôles dans les pipelines CI/CD : scans IaC, vérification que les jeux de données sensibles sont taggés, tests de privacy avant promotion en production, et gating pour empêcher le déploiement si des risques critiques sont détectés.
- Git hooks / pipelines qui refusent la mise en prod si des secrets sont détectés
- Checks automatisés pour s'assurer que le chiffrement est activé sur tous les buckets
- Procédures d'audit continu des modèles et des accès, avec alerting en cas d'anomalies
Avec ces éléments en place, on passe d'une posture réactive à une posture proactive : on peut chiffrer la réduction de la surface d'attaque (par ex. diminution du nombre d'endpoints publics, baisse du nombre de comptes à privilèges) et montrer des gains concrets à la direction.
Si vous le souhaitez, je peux vous partager un template de DPIA adapté aux pipelines ML et un checklist d'audit technique prêt à être exécuté en 1 journée par une petite équipe — dites-moi votre stack technique (cloud, orchestrateur, outils CI) et j'adapte les recommandations.